Study
노드 개발자가 asyncio를 공부하면서 알게 된 것들
Node.js로 서버를 개발하던 사람이 Python의 비동기 프로그래밍을 직접 파헤쳐 본 기록.
들어가며
그동안 백엔드 개발을 하면서 주로 노드와 NestJS를 사용했는데, 최근 AI 백엔드 개발에 관심이 생겨 파이썬을 공부하기 시작했다. 사실 새로운 언어를 공부할 때마다 문법부터 하나하나 살펴보는 건 별로 좋아하지 않는다. 기존에 알고 있던 개념을 다른 언어에서는 어떻게 구현하는지 비교하는 게 더 재밌기도 하고...ㅎ
그래서 가장 먼저 살펴본 게 비동기 처리였다. 노드에서 async/await는 워낙 자주 사용하다 보니 파이썬에서도 비슷하겠거니 했는데, 막상 asyncio를 살펴보니까 익숙하면서도 조금 다른 부분들이 있었다. 특히 코루틴의 실행 방식이나 작업 취소 처리처럼 평소 크게 의식하지 않았던 부분들을 다시 확인하게 됐는데 이번 글에서는 그 내용을 정리해 보려고 한다.
1. Node.js에서는 비동기 작업을 어떻게 처리했을까?
API를 개발하다 보면 하나의 요청에서 여러 데이터를 조회해야 하는 상황이 생긴다. 예를 들어 사용자 정보와 상품 정보, 추천 데이터를 조회해야 한다고 가정해 보자. 각각의 조회에 1초씩 걸린다면 순차적으로 처리했을 때 총 3초 정도가 필요하다.
const user = await getUser();
const product = await getProduct();
const recommendation = await getRecommendation();
세 작업이 서로 의존하지 않는다면 굳이 앞선 작업이 끝날 때까지 기다릴 이유가 없다. 노드에서는 이런 상황에서 Promise.all()을 사용할 수 있다.
const [user, product, recommendation] = await Promise.all([
  getUser(),
  getProduct(),
  getRecommendation(),
]);
각 작업의 대기 시간이 겹치기 때문에 전체 실행 시간은 가장 오래 걸리는 작업에 가까워진다.
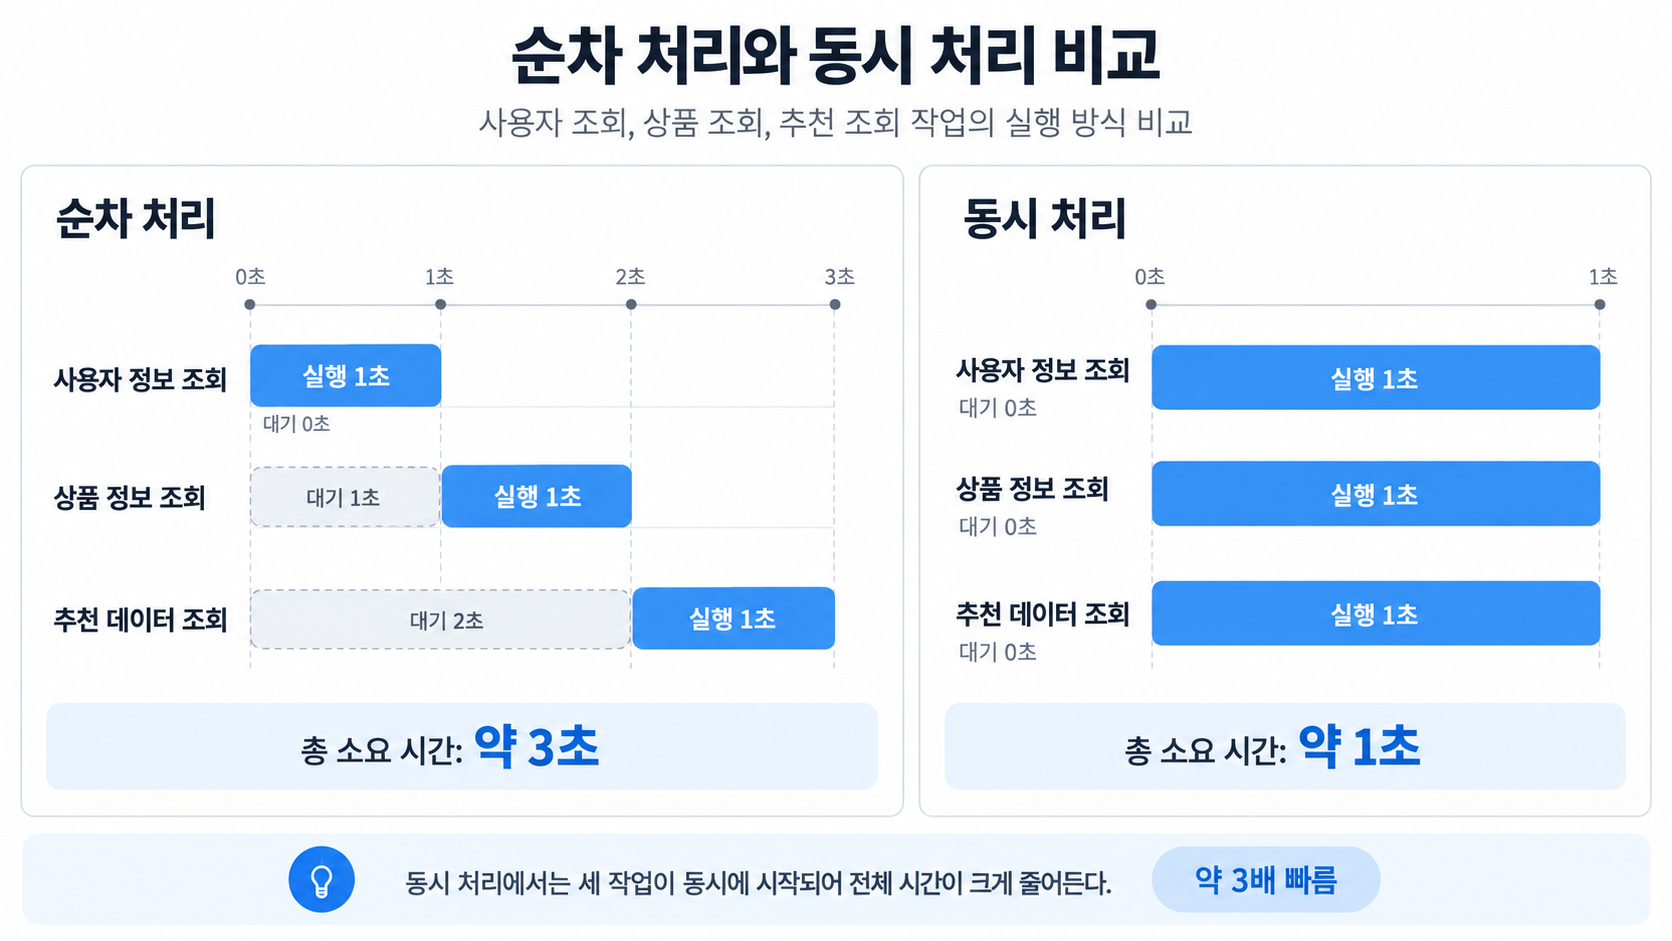
물론 Promise.all()을 사용한다고 모든 작업이 여러 스레드에서 병렬 실행되는 건 아니다. I/O 작업을 기다리는 동안 다른 작업을 처리할 수 있다는 게 중요한 부분이다. 여기까지는 익숙한 내용이었고 파이썬에서도 비슷한 방식으로 처리할 수 있는지 찾아봤다.
2. Python의 asyncio.gather()
파이썬에서는 asyncio를 통해 비동기 작업을 다룰 수 있고, 여러 작업을 함께 실행할 때는 asyncio.gather()를 사용할 수 있었다.
일단 간단한 예제부터 살펴봤다.
순차 실행
import asyncio
import time

async def fetch_data(id):
    await asyncio.sleep(1)
    return f"Result {id}"

async def main():
    start = time.perf_counter()

    result1 = await fetch_data(1)
    result2 = await fetch_data(2)
    result3 = await fetch_data(3)

    print(result1, result2, result3)
    print(f"실행 시간: {time.perf_counter() - start:.2f}초")

asyncio.run(main())
각각의 작업을 await하고 있으니 첫 번째 작업이 완료된 뒤 두 번째 작업이 실행되는 구조다. asyncio.sleep(1)을 사용했기 때문에 총 실행 시간은 약 3초가 예상된다. 이번에는 동일한 코드를 gather()로 변경했다.
동시 실행
import asyncio
import time

async def fetch_data(id):
    await asyncio.sleep(1)
    return f"Result {id}"

async def main():
    start = time.perf_counter()

    results = await asyncio.gather(
        fetch_data(1),
        fetch_data(2),
        fetch_data(3),
    )

    print(results)
    print(f"실행 시간: {time.perf_counter() - start:.2f}초")

asyncio.run(main())
세 작업이 동시에 대기할 수 있기 때문에 이번에는 약 1초가 예상된다.
※ 실제 측정값이 아닌 코드상 예상 시간이다.
여기까지는 노드의 Promise.all()과 거의 비슷하게 느껴졌다. 그런데 조금 더 찾아보니 예외 처리와 작업의 생명주기를 관리하는 방법에서 알아둘 부분이 있었다.
3. 작업 하나가 실패하면 나머지는 어떻게 될까?
노드에서 비동기 함수를 꽤 써봤으니 처음엔 걍 asyncio.gather()가 파이썬 버전 Promise.all()인 줄 알았다. 근데 예외 처리 쪽을 살펴보니 조금 더 알아둘 부분이 있었다. 크크
gather()는 기본 설정에서 하나의 작업이 실패하더라도 나머지 작업을 자동으로 취소하지 않는다. 다음과 같은 상황을 생각해 보자.
import asyncio

async def fetch_data(name, delay, fail=False):
    await asyncio.sleep(delay)

    if fail:
        raise RuntimeError(f"{name} 조회 실패")

    print(f"{name} 조회 완료")
    return name

async def main():
    try:
        await asyncio.gather(
            fetch_data("사용자", 1, fail=True),
            fetch_data("상품", 2),
            fetch_data("추천", 3),
        )
    except RuntimeError as e:
        print(f"예외 발생: {e}")

    # 나머지 작업이 어떻게 되는지 확인
    await asyncio.sleep(3)

asyncio.run(main())
위 코드에서는 사용자 조회가 1초 후 실패하지만, 상품 조회와 추천 조회는 이미 스케줄링되어 있는 상태다. 따라서 첫 번째 예외가 main()으로 전달되더라도 다른 작업들은 계속 진행될 수 있다.
예상되는 출력은 다음과 같다.
예외 발생: 사용자 조회 실패
상품 조회 완료
추천 조회 완료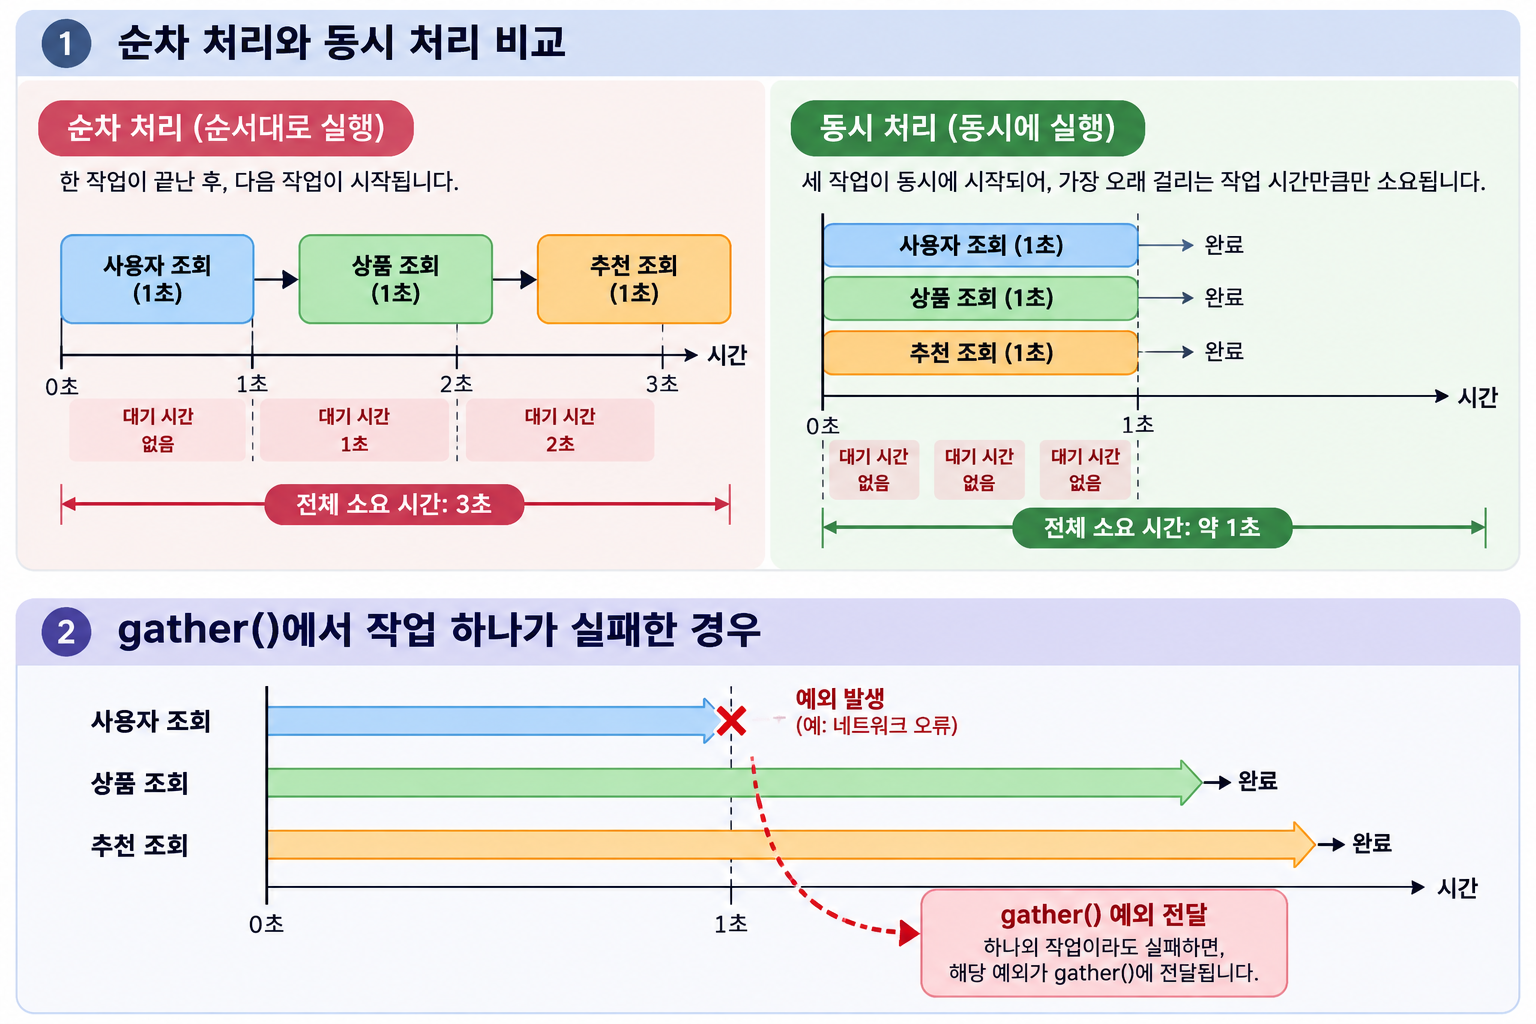
이걸 모르고 외부 API 여러 개를 묶어서 호출했더라면... 예외는 이미 반환됐는데 나머지 요청은 계속 돌고 있었겠지... 생각해 보니 실무에서도 이런 차이를 모르고 쓰면 골치 꽤나 아팠겠다고 생각했다. ㅋㅋ 여기서 정확히 짚고 넘어갈 부분이 하나 있다. 사실 노드의 Promise.all()도 마찬가지로 하나가 실패한다고 나머지 Promise를 자동으로 취소하지 않는다. 즉, 이 동작 자체가 파이썬만의 차이점은 아니었다. 오히려 이번에 공부하면서 새로 알게 된 건 파이썬에서는 관련된 작업들을 하나의 그룹으로 관리하는 TaskGroup을 제공한다는 점이었다.
TaskGroup은 뭐가 다를까?
파이썬 3.11부터는 asyncio.TaskGroup을 사용할 수 있다.
import asyncio

async def fetch_data(name, delay, fail=False):
    try:
        await asyncio.sleep(delay)

        if fail:
            raise RuntimeError(f"{name} 조회 실패")

        print(f"{name} 조회 완료")
        return name

    except asyncio.CancelledError:
        print(f"{name} 작업 취소")
        raise

async def main():
    try:
        async with asyncio.TaskGroup() as group:
            group.create_task(
                fetch_data("사용자", 1, fail=True)
            )
            group.create_task(
                fetch_data("상품", 2)
            )
            group.create_task(
                fetch_data("추천", 3)
            )

    except* RuntimeError as e:
        print("작업 그룹에서 예외 발생")

asyncio.run(main())
이번에는 사용자 조회에서 예외가 발생하면 TaskGroup이 나머지 작업에 취소를 요청하고, 해당 작업들이 종료될 때까지 기다린다. 예상 출력은 다음과 같다. 취소 메시지 사이의 순서는 달라질 수 있다.
상품 작업 취소
추천 작업 취소
작업 그룹에서 예외 발생
물론 TaskGroup도 실행 중인 모든 작업을 강제로 즉시 중단시키는 건 아니다. 취소는 협력적으로 처리되기 때문에 작업이 취소 요청에 제대로 응답해야 하고, 외부 시스템에서 이미 처리한 작업까지 되돌려 주지는 않는다.
특히 DB 변경이나 외부 API 호출이 섞여 있다면 취소 이후의 데이터 정합성까지 별도로 고려해야 한다.
gather()와 TaskGroup 중 어느 쪽이 무조건 좋다고 보기는 어렵지만, 관련 작업 중 하나가 실패했을 때 나머지 작업을 어떻게 처리할지에 따라 선택할 수 있겠다는 생각이 들었다.
4. async 함수 호출 방식도 조금 달랐다.
이어서 코루틴의 실행 방식도 살펴봤다.
노드에서는 비동기 함수를 호출하면 함수 본문이 실행되기 시작하고 Promise를 반환한다.
async function hello() {
  console.log("Hello!");
}

hello();
위 코드는 hello()를 호출하는 시점에 Hello!가 출력된다.
그런데 파이썬에서는 같은 느낌으로 코드를 작성해도 바로 실행되지 않는다.
async def hello():
    print("Hello!")

hello()hello()를 호출하면 함수 본문이 실행되는 게 아니라 코루틴 객체를 반환하기 때문이다. 실제로 실행하려면 await하거나 Task로 스케줄링해야 한다.
import asyncio

async def hello():
    print("Hello!")

asyncio.run(hello())
노드에서 익숙하게 쓰던 방식과는 조금 달랐는데, 특히 여러 코루틴을 생성하는 것과 실행하는 것이 별개의 과정이라는 점이 눈에 들어왔다.
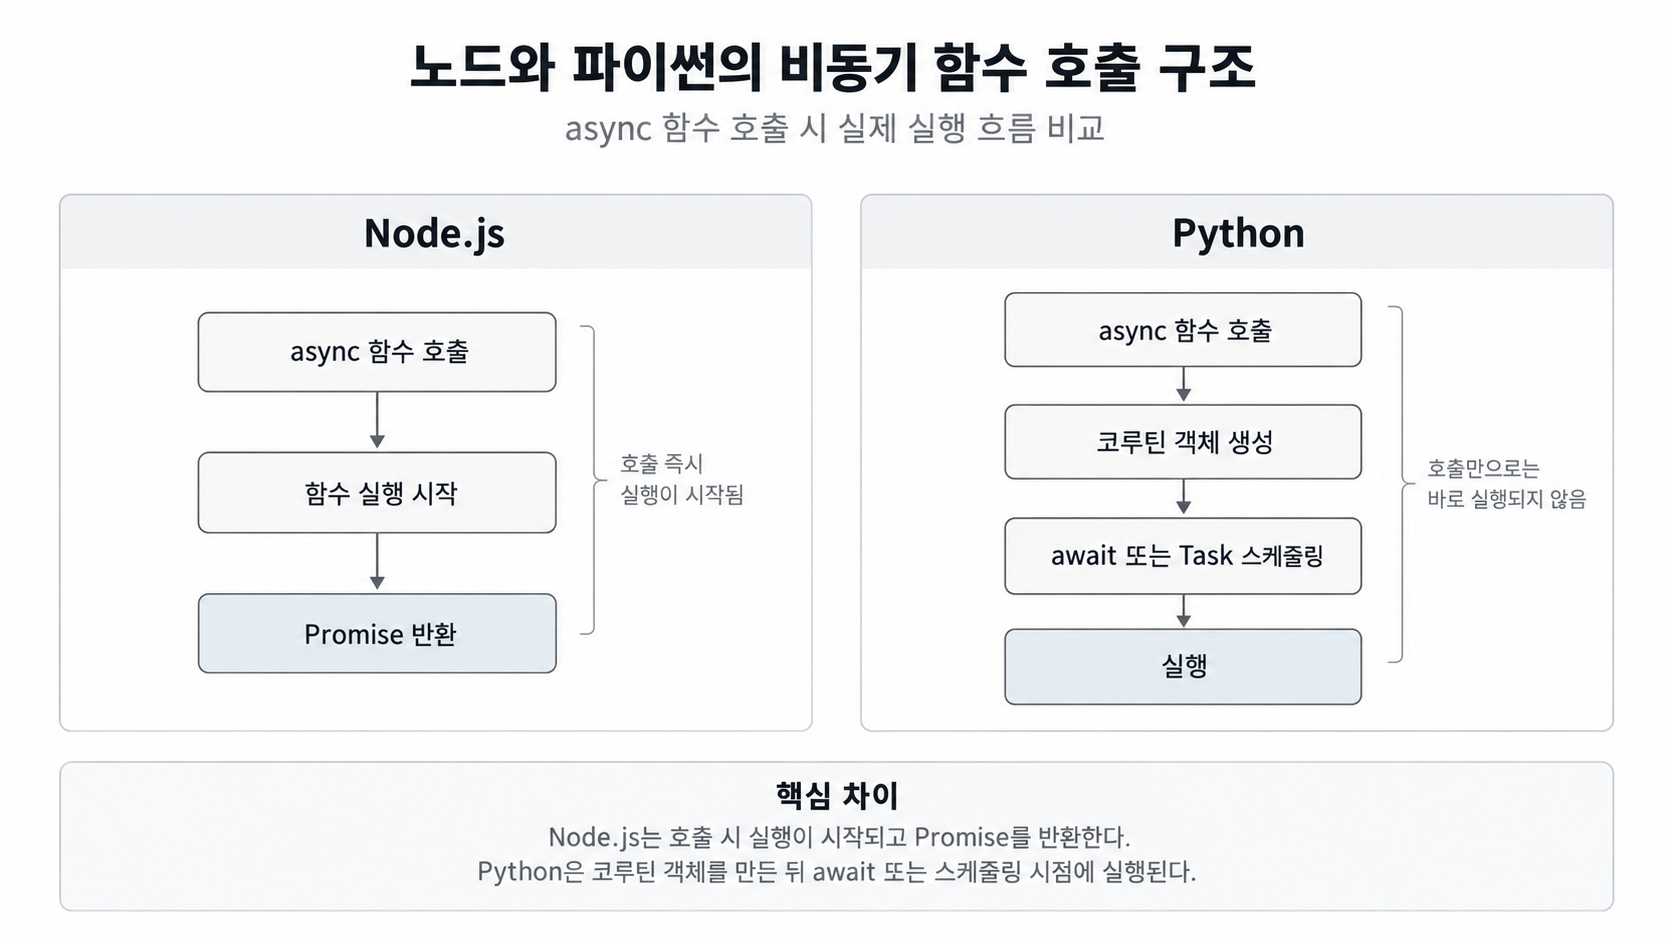
다만 여기서 사용하는 asyncio.run()은 일반적인 독립 실행 프로그램에서 이벤트 루프를 관리하기 위한 함수다. FastAPI 같은 환경에서는 ASGI 서버가 이벤트 루프를 관리하기 때문에 요청 처리 코드 안에서 매번 호출하는 방식으로 사용하지 않는다.
5. async def 안에서 동기 함수를 실행하면?
비동기 처리 방식을 공부하면서 개인적으로 가장 중요하다고 생각한 부분은 블로킹 작업이었다. async def로 선언했다고 해서 내부 코드까지 전부 비동기적으로 실행되는 건 아니었다. 예를 들어 다음처럼 asyncio.sleep()을 사용하는 경우를 살펴보자.
import asyncio
import time

async def fetch_data(id):
    print(f"시작: {id}")
    await asyncio.sleep(1)
    print(f"완료: {id}")

async def main():
    start = time.perf_counter()

    await asyncio.gather(
        fetch_data(1),
        fetch_data(2),
        fetch_data(3),
    )

    print(f"실행 시간: {time.perf_counter() - start:.2f}초")

asyncio.run(main())asyncio.sleep()은 대기하는 동안 이벤트 루프에 제어권을 넘겨주기 때문에 다른 코루틴이 실행될 수 있다. 따라서 세 작업은 거의 같은 시점에 시작하고, 약 1초 후 완료될 것으로 예상된다. 그런데 asyncio.sleep()을 time.sleep()으로 변경하면 어떻게 될까?
async def fetch_data(id):
    print(f"시작: {id}")
    time.sleep(1)
    print(f"완료: {id}")
이번에는 대기하는 동안 현재 스레드가 차단된다.
결국 같은 이벤트 루프에서 다른 코루틴을 실행할 수 없기 때문에 세 작업이 사실상 순차적으로 진행되고, 약 3초가 걸릴 것으로 예상된다.
사실 첨엔 별생각 없었는데 (둘 다 함수 안에서 1초 기다리는 건 똑같으니까 ㅎ)
근데 이 차이가 실제 API 서버에서는 꽤 중요할 것 같았다. 예를 들어 FastAPI의 비동기 엔드포인트 안에서 동기식 외부 API 클라이언트나 오래 걸리는 파일 처리 함수를 실행하면 해당 이벤트 루프가 차단될 수 있다. 그동안 노드로 개발하면서 이벤트 루프를 막는 작업을 조심해야 한다는 건 알고 있었는데, 파이썬에서도 어떤 라이브러리를 사용하는지까지 확인해야 한다는 점을 다시 생각하게 됐다. 물론 블로킹 함수를 모두 비동기 함수로 바꿔야 하는 건 아니다.
파이썬에서는 asyncio.to_thread()를 이용해 블로킹 I/O 함수를 별도 스레드에서 실행할 수도 있다.
import asyncio
import time

def blocking_task():
    time.sleep(1)
    return "완료"

async def main():
    result = await asyncio.to_thread(blocking_task)
    print(result)

asyncio.run(main())
다만 별도 스레드를 사용하는 것이 무조건 성능 향상을 의미하는 건 아니고, 특히 CPU 연산이 많은 작업이라면 GIL이나 프로세스 분리 같은 부분도 고려해야 한다. 이 부분은 추후 AI 모델 추론을 직접 연결할 때 좀 더 자세히 살펴보려고 한다.
6. 그렇다면 동시 실행은 많을수록 좋을까?
여러 요청을 동시에 처리할 수 있다는 건 장점이지만, 그렇다고 요청 1,000개를 한꺼번에 실행하는 게 항상 좋은 건 아니다. 외부 API에는 호출 제한이 있을 수 있고, DB 커넥션이나 네트워크 연결에도 한계가 있기 때문이다. 노드에서도 외부 API와 통신하면서 연결 유지 시간이나 소켓 재사용 문제를 겪어본 적이 있었는데, 결국 비동기 처리뿐만 아니라 요청을 얼마나 보내고 어떻게 관리하는지도 중요하다는 걸 다시 느꼈다.
파이썬에서는 asyncio.Semaphore를 사용해 특정 작업의 동시 실행 수를 제한할 수 있다.
import asyncio
import time

semaphore = asyncio.Semaphore(5)

async def fetch_data(id):
    async with semaphore:
        await asyncio.sleep(1)
        return f"Result {id}"

async def main():
    start = time.perf_counter()

    results = await asyncio.gather(
        *(fetch_data(i) for i in range(20))
    )

    print(f"처리한 작업: {len(results)}개")
    print(f"실행 시간: {time.perf_counter() - start:.2f}초")

asyncio.run(main())
20개의 작업을 스케줄링하되 세마포어로 보호된 구간에는 최대 5개만 동시에 진입하도록 제한했다. 각 작업이 1초씩 기다리므로 전체 실행 시간은 약 4초로 예상된다.
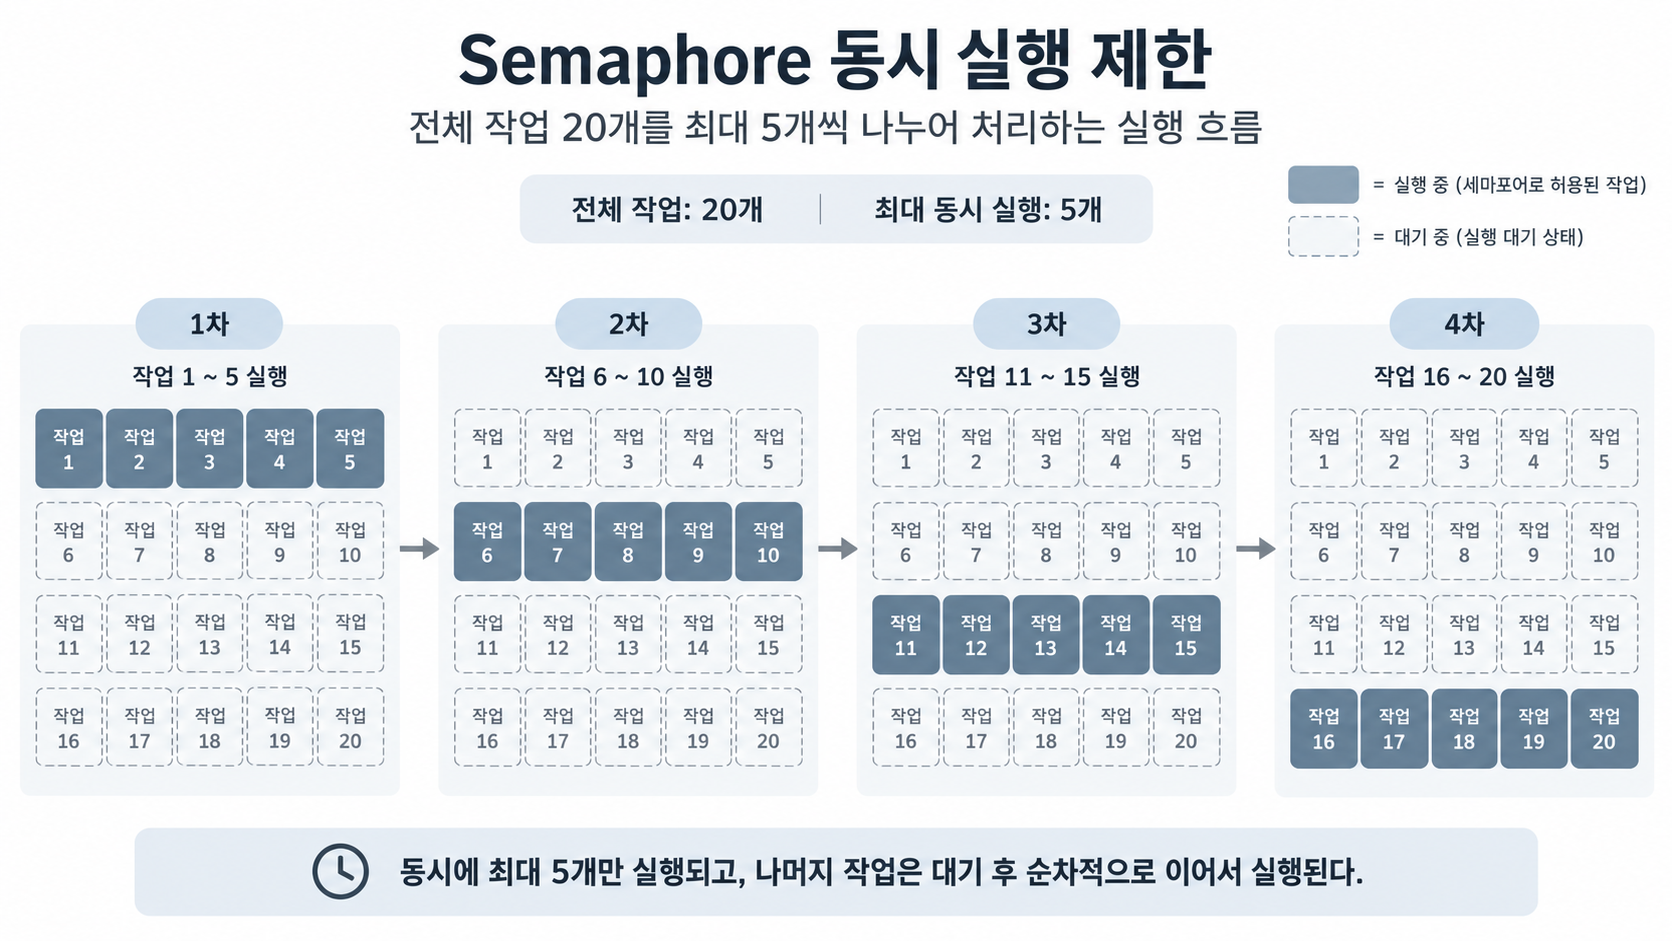
실서비스에서는 적절한 동시 실행 수를 정하는 게 중요할 텐데, 이런 값도 감으로 정하기보다는 실제 부하 테스트 결과를 기준으로 판단하는 편이 맞을 것 같다.
7. AI 백엔드에서는 어떻게 적용할 수 있을까?
이번에 파이썬을 공부하기 시작한 이유가 AI 백엔드에 대한 관심이었으니 실제 서비스에서는 이런 개념을 어떻게 활용할 수 있을지도 생각해 봤다. 예를 들어 사용자가 AI 캐릭터와 대화하는 서비스를 만든다고 하면 다음과 같은 과정이 필요할 거다.
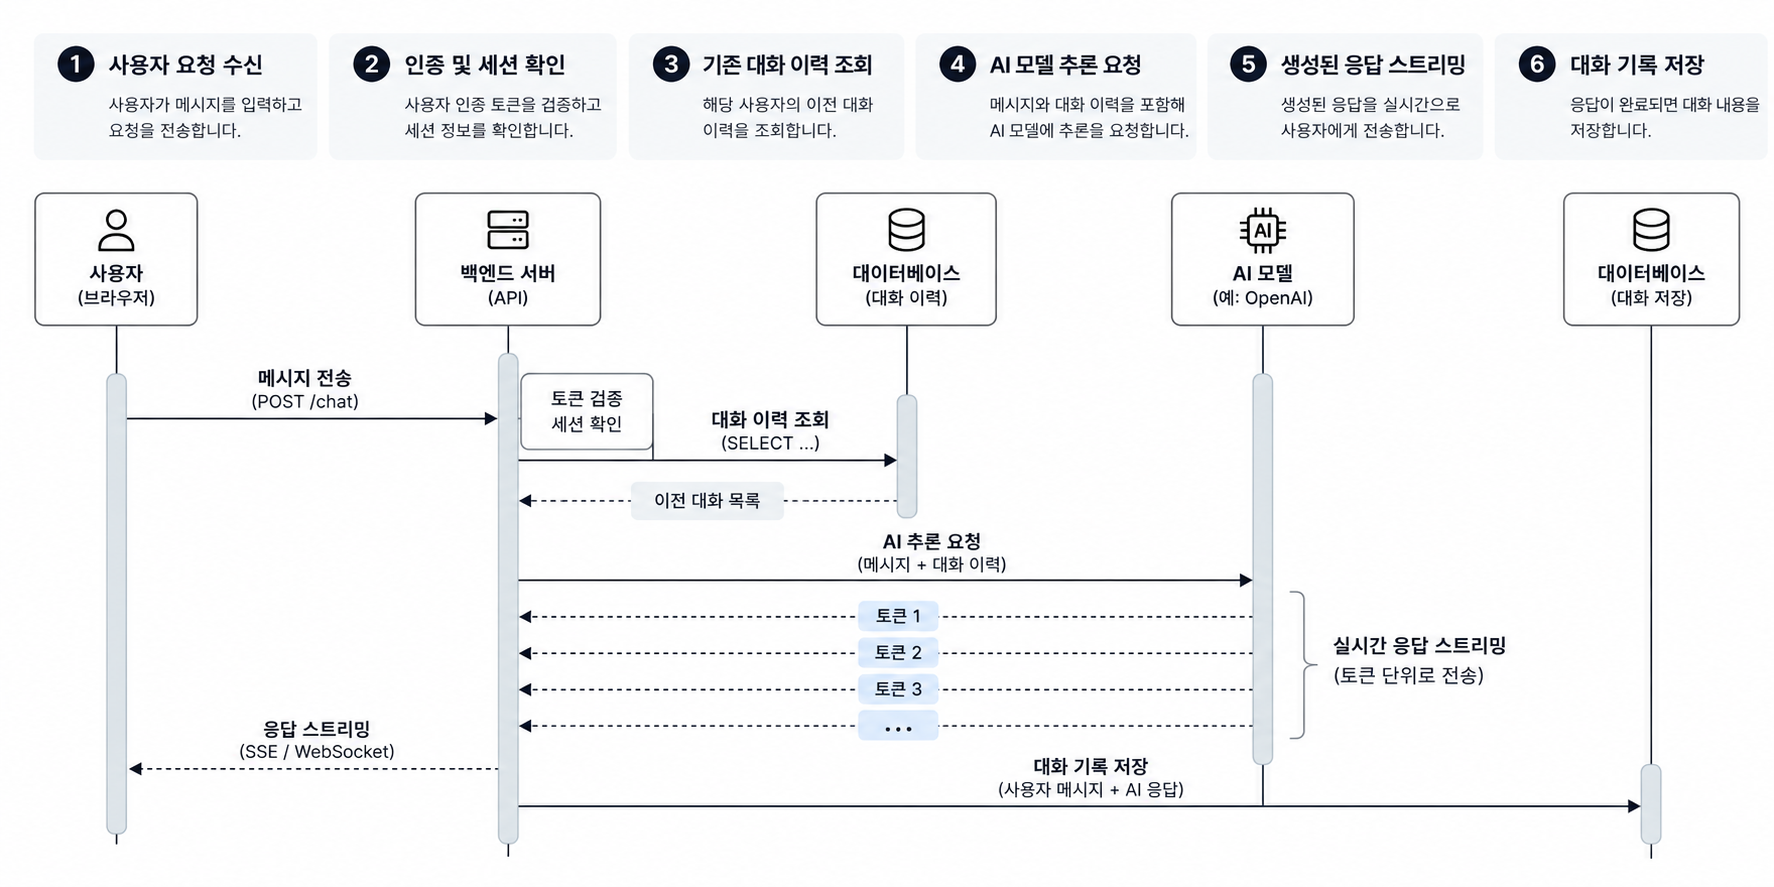
여기서 사용자 설정이나 독립적인 캐시 데이터를 조회하는 작업은 동시에 처리할 수 있겠지만, 이전 대화 내용을 바탕으로 AI 응답을 생성해야 한다면 대화 이력 조회가 먼저 완료되어야 한다. 또 모델 추론에는 시간이 걸릴 수 있기 때문에 응답이 모두 생성될 때까지 기다리는 대신 스트리밍으로 전달하면 사용자가 첫 응답을 받기까지의 체감 대기 시간을 줄일 수도 있을 것이다. 결국 모든 작업을 비동기로 만드는 것보다, 동시에 실행할 수 있는 작업과 순서를 보장해야 하는 작업을 구분하는 게 더 중요하겠다는 생각이 들었다. 그리고 실제 AI 추론이 동기식으로 실행되는 상황이라면 이벤트 루프를 막지 않도록 별도 실행 환경이나 모델 서빙 구조도 고려해야 할 것 같다.
마무리
처음에는 노드에서 사용하던 async/await랑 크게 다르지 않을 거라고 생각했는데, 공부하다 보니 코루틴의 실행 방식부터 작업 취소, 블로킹 함수 처리까지 확인할 부분이 꽤 있었다. 특히 gather()와 TaskGroup의 차이는 단순히 여러 작업을 동시에 실행하는 것뿐만 아니라 실패했을 때 어떻게 정리할지까지 생각해 볼 수 있어서 흥미로웠다. 다만 이번에는 asyncio.sleep()을 이용해 동시 실행 구조를 살펴본 거라 실제 네트워크 요청이나 API 서버의 성능을 검증한 건 아니다.
다음에는 FastAPI로 간단한 API 서버를 만들어서 일반 def와 async def 엔드포인트의 동작을 비교하고, 동시 요청 수가 늘어날 때 실제 응답 시간이 어떻게 달라지는지 확인해 보려고 한다.
참고 자료
댓글
익명 캐릭터로 가볍게 이야기를 남겨 주세요.