Debug
Node.js HTTP Keep-Alive와 TCP 소켓 재사용
서버야 우리 아직 연결 중인데
1. 분명 정상적인 API인데, 가끔 요청이 실패한다
백엔드 개발을 하면서 가장 난감한 오류 중 하나는 재현이 일정하지 않은 오류라고 생각한다. API가 항상 실패한다면 원인을 찾기가 비교적 쉽다.
요청 데이터가 잘못되었는지, 인증이 실패했는지, DB 쿼리에서 문제가 발생했는지 확인하면 된다. 그런데 이번에는 조금 달랐다.
어느 날 테스트를 계속 진행하는데 서버에서 외부 API를 호출하는 과정에서 간헐적으로 socket hang up이 발생했다.
Error: socket hang up
    at Socket.socketOnEnd (node:_http_client:...)
    at Socket.emit (node:events:...)

{
  code: 'ECONNRESET'
}
위 로그는 당시 오류의 형태를 설명하기 위해 단순화한 예시다.
이상한 점은 다음과 같았다.
- 외부 API 서버가 완전히 다운된 상황은 아님.
- 동일한 요청을 다시 호출하면 정상적으로 응답하는 경우가 있음.
- 특정 비즈니스 로직이나 요청 데이터만의 문제로 보기 어려움.
- 요청과 요청 사이의 시간 간격이 영향을 미칠 가능성이 있음.
처음에는 일반적인 네트워크 오류라고 생각했다. 하지만 장애 발생 조건을 분석하다 보니 HTTP 연결의 생명주기를 확인해야겠다는 생각이 들었다. 그리고 확인한 설정에서 중요한 단서를 발견했다.
외부 API 서버와 우리 서버의 연결 유지 시간이 달랐던 것이다.
2. 먼저 확인한 서버 환경
당시 통신에 참여하는 두 서버의 연결 관련 설정을 확인해봤다.
여기서 중요한 점은 60초라는 값이 정확히 어떤 옵션에 적용된 값인지다.
Node.js에서는 timeout, keepAliveMsecs, keepAliveTimeout, freeSocketTimeout 등이 모두 서로 다른 의미를 가진다. 따라서 단순히 '클라이언트 Keep-Alive가 60초'라고 표현하는 것만으로는 실제 연결 동작을 설명하기 어렵다.
다만 당시 조사에서 확인한 외부 서버의 약 1초 유휴 연결 종료와 우리 서버 측 60초 유지 설정의 차이는 소켓 재사용 문제를 의심할 수 있는 단서였다. 우선 이 현상을 이해하려면 HTTP Keep-Alive가 어떻게 동작하는지부터 알아야 한다.
3. HTTP Keep-Alive는 무엇일까?
HTTP 요청을 처리하려면 클라이언트와 서버 사이에 네트워크 연결이 필요하다. HTTP/1.1에서 TCP 연결을 재사용하지 않는 상황을 생각해 보자. 클라이언트가 API를 호출할 때마다 새로운 TCP 연결을 생성해야 한다.
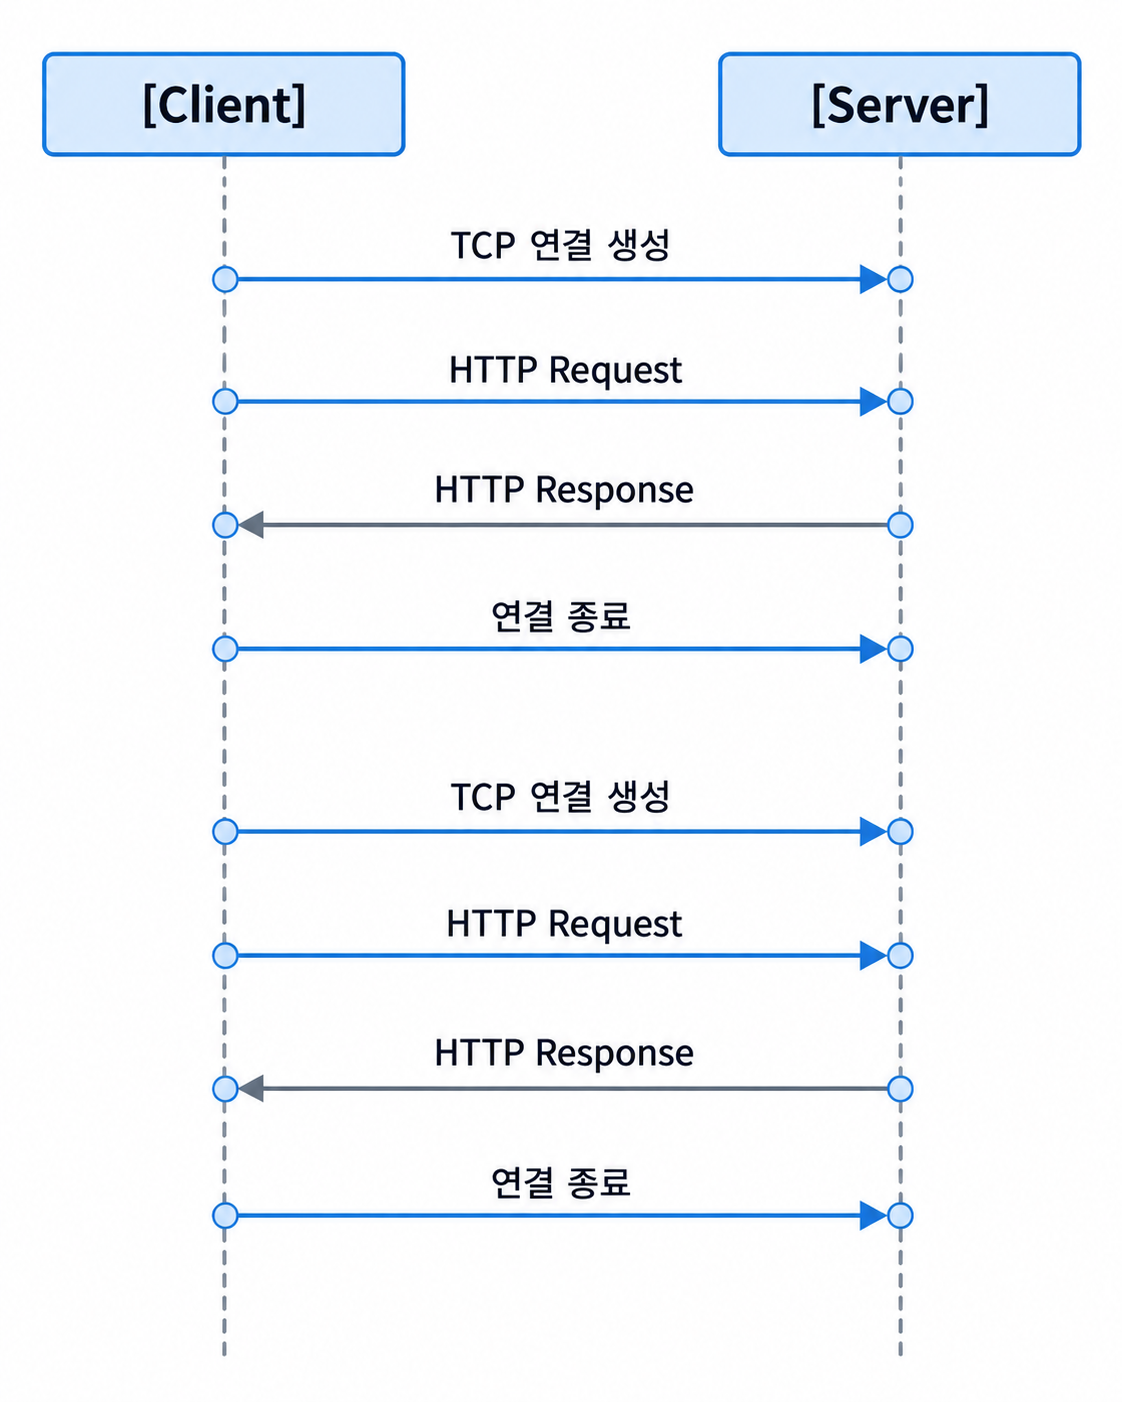
API 호출이 많다면 매번 연결을 만드는 과정이 반복된다. TCP 연결을 생성하는 데는 핸드셰이크가 필요하고, HTTPS라면 TLS 연결을 설정하는 과정도 추가될 수 있다. 이러한 비용을 줄이기 위해 사용하는 것이 HTTP Keep-Alive다.
Keep-Alive를 적용하면?
HTTP Keep-Alive는 하나의 TCP 연결을 여러 HTTP 요청에 재사용할 수 있도록 한다.
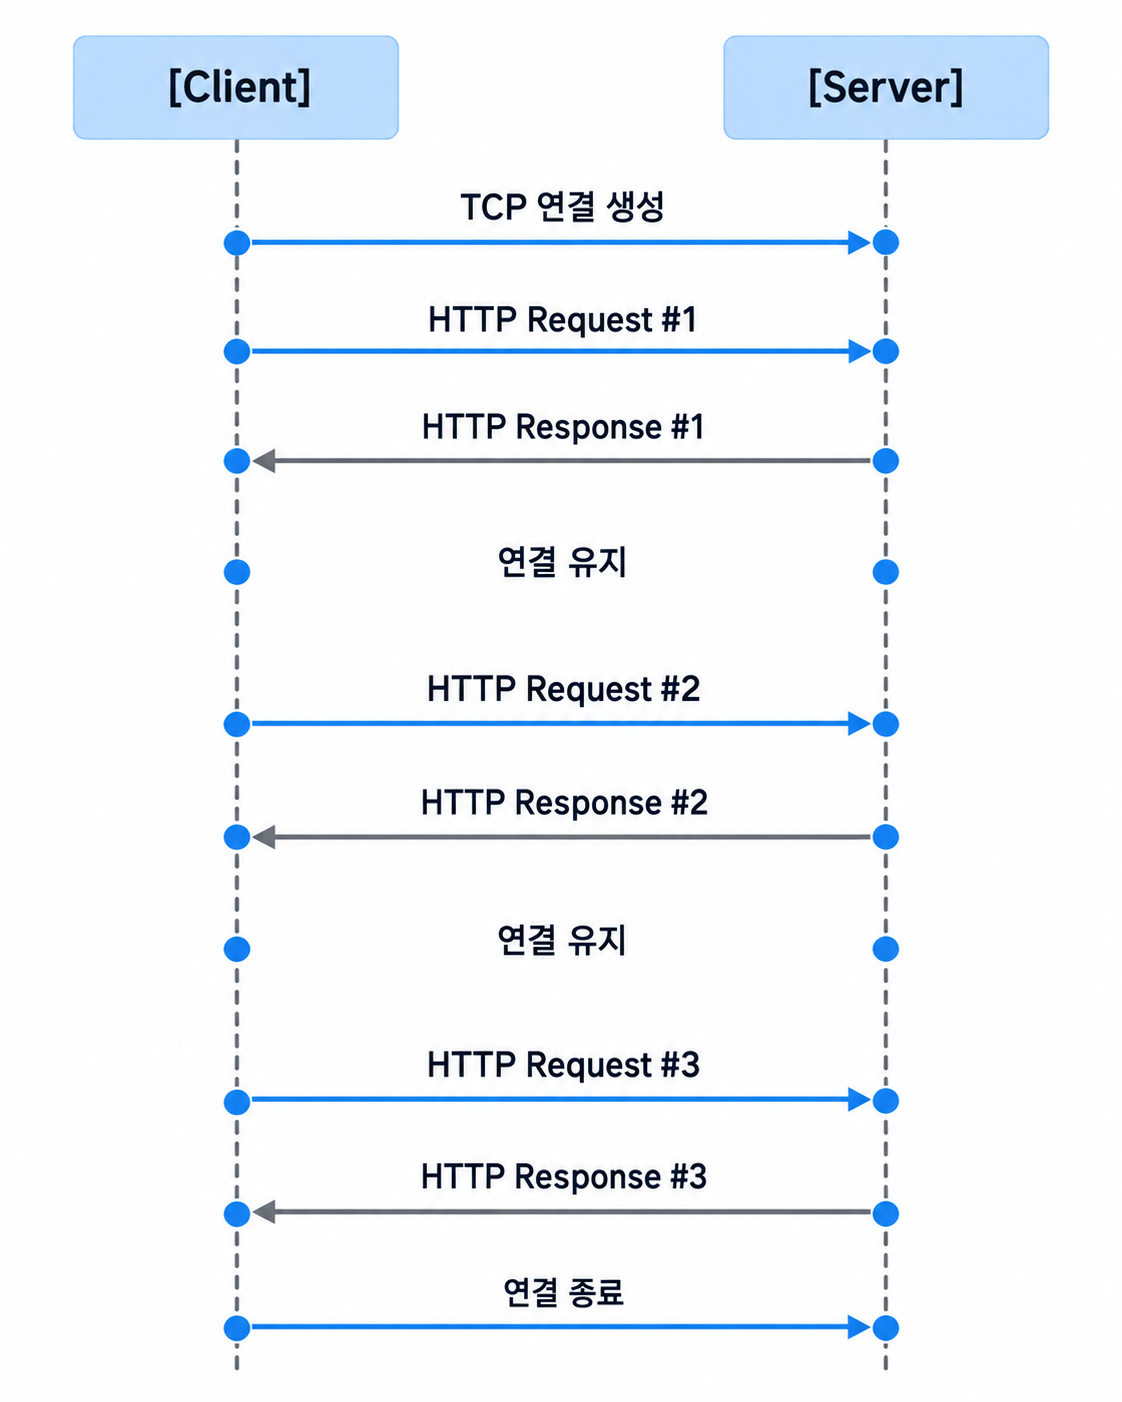
이렇게 연결을 재사용하면 다음과 같은 장점이 있다.
- TCP 연결 생성 횟수를 줄일 수 있다.
- HTTPS 환경에서 반복적인 TLS 연결 설정 비용을 줄일 수 있다.
- 요청 처리 지연 시간을 줄일 수 있다.
- 연결 생성 및 종료에 드는 서버 리소스를 절약할 수 있다.
반복적으로 외부 API를 호출하는 백엔드 서버에서는 상당히 유용한 기능이라고 생각해 적용해두었다. 그렇다면 나는 왜 Keep-Alive를 사용하면서 왜 오류가 발생했을까?
문제는 연결을 유지할 수 있다는 것과, 그 연결이 지금도 살아 있다는 것이 서로 다른 의미라는 점이다.
4. 서버와 클라이언트는 연결 상태를 항상 똑같이 알고 있을까?
이번 문제에서 가장 중요했던 부분이다. 예를 들어 외부 API 서버는 마지막 응답 이후 1초 동안 새로운 요청이 없다면 연결을 종료하도록 구성되어 있다고 가정해 보자. 반면 클라이언트는 유휴 소켓을 최대 60초까지 재사용할 수 있도록 설정했다고 가정하자. 여기서 말하는 60초는 유휴 소켓 유지 정책을 뜻하는 가상의 설정이며, keepAliveMsecs와는 다르다.
다음과 같은 상황이 발생할 수 있다.
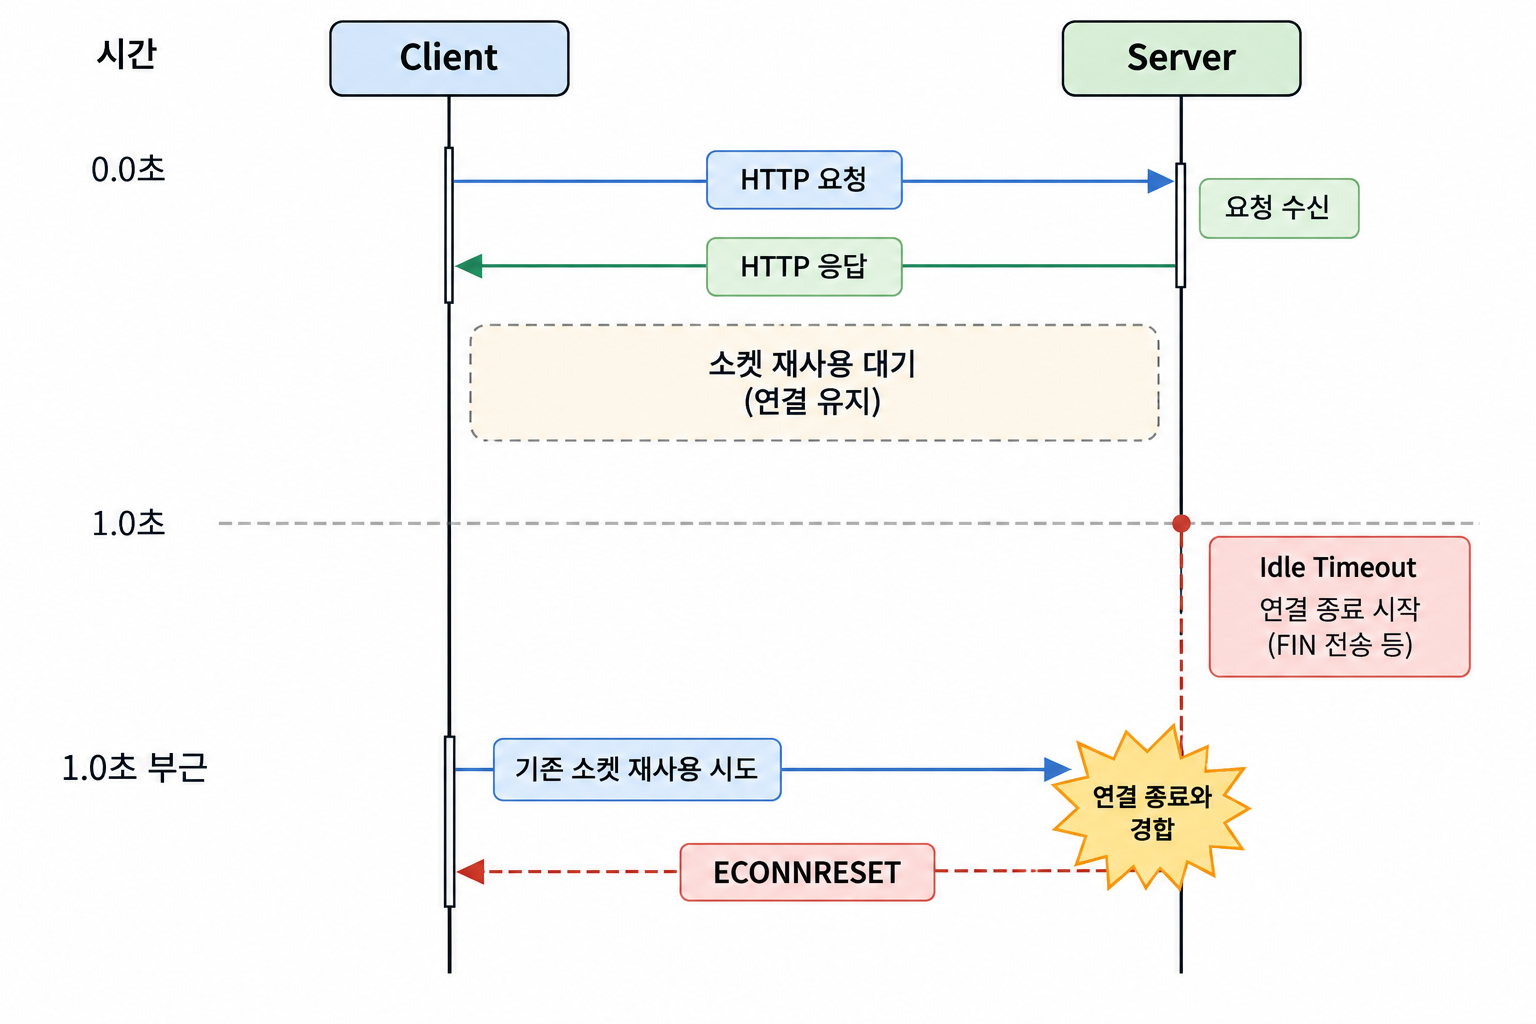
여기서 클라이언트가 반드시 60초 동안 연결 종료를 모르는 것은 아니다. 정상적인 경우 서버에서 연결 종료 신호인 TCP FIN을 보내면, Node.js는 해당 연결이 종료되었다는 것을 감지하고 소켓 풀에서 제거한다. 따라서 유휴 연결 유지 시간이 서로 다르다고 해서 오류가 무조건 발생하는 것은 아니다.
문제가 되는 상황은 서버의 연결 종료와 클라이언트의 소켓 재사용이 겹치는 순간이다.
예를 들어 서버가 연결을 닫는 중인데 클라이언트가 아직 재사용 가능한 소켓이라고 판단해 새로운 요청을 보내면 오류가 발생할 수 있다. 이것이 소켓 재사용 과정의 Race Condition이다.
Race Condition이란?
둘 이상의 동작이 실행되는 순서나 시점에 따라 결과가 달라지는 상황을 말한다. 이번 사례에 적용하면 다음과 같다.
- 서버는 유휴 연결을 종료하려고 한다.
- 클라이언트는 기존 연결로 새로운 요청을 전송하려고 한다.
- 두 동작의 순서에 따라 요청이 성공하거나 실패할 수 있다.
따라서 같은 API를 호출하더라도 어떤 시점에는 정상 응답을 받고, 어떤 시점에는 ECONNRESET이 발생할 수 있다. 바로 이 부분이 간헐적인 오류를 이해하는 핵심이었다.
5. socket hang up과 ECONNRESET의 차이는?
로그를 분석하다 보면 두 표현이 함께 등장하는 것을 볼 수 있다.
Error: socket hang up
code: 'ECONNRESET'
처음에는 서로 다른 오류인지 궁금했다. 하지만 Node.js HTTP 클라이언트에서는 연결이 예상치 못하게 종료되어 응답을 완료하지 못한 상황에서 socket hang up 메시지와 ECONNRESET 코드가 함께 나타날 수 있다.
socket hang up
socket hang up은 Node.js에서 HTTP 통신 중 연결이 예상과 다르게 종료되었을 때 나타날 수 있는 오류 메시지다.
ECONNRESET
ECONNRESET은 연결이 비정상적으로 끊어졌음을 나타내는 오류 코드다.
여기서 주의해야 할 점이 있다.
ECONNRESET이 발생했다고 해서 무조건 Keep-Alive가 원인인 것은 아니다.
다음과 같은 상황에서도 발생할 수 있다.
- 서버가 요청 처리 중 연결을 종료한 경우
- 프록시 또는 로드밸런서에서 연결이 끊긴 경우
- 네트워크 장비가 연결을 재설정한 경우
- 서버 프로세스가 비정상적으로 종료된 경우
- 기존 연결을 재사용하려다 종료된 소켓과 충돌한 경우
따라서 오류 코드만으로 원인을 확정할 수 없다.
이번 사례에서는 외부 서버의 짧은 유휴 연결 종료 시간과 클라이언트의 소켓 재사용 동작이 핵심적인 조사 대상이었다.
6. Node.js에서는 HTTP 연결을 어떻게 관리할까?
Node.js에서 HTTP 요청을 보낼 때 중요한 역할을 하는 것이 http.Agent다.
http.Agent는 HTTP 클라이언트 연결을 관리하는 객체다.
주요 역할은 다음과 같다.
- TCP 연결 생성
- 요청에 소켓 할당
- 유휴 소켓 관리
- 기존 연결 재사용
- 연결 종료 시 소켓 풀 정리
Keep-Alive를 사용하면 요청 처리가 끝난 소켓을 즉시 제거하는 대신, 다음 요청을 위해 보관할 수 있다.
간단한 코드 예시
import * as http from 'node:http';

const agent = new http.Agent({
  keepAlive: true,
  maxSockets: 100,
  maxFreeSockets: 10,
});

http.get(
  'http://localhost:3000/api',
  { agent },
  (response) => {
    response.on('data', () => {});

    response.on('end', () => {
      console.log('요청 완료');
    });
  },
);
이 코드는 동일한 호스트에 반복적으로 요청할 때 소켓을 재사용할 수 있도록 구성한 예시다. 여기서 각 옵션의 역할을 구분할 필요가 있다.
특히 keepAliveMsecs는 많이 혼동할 수 있는 옵션이다.
keepAliveMsecs = 유휴 소켓 보관 시간?
처음 이름만 보면 그렇게 생각하기 쉽다.
const agent = new http.Agent({
  keepAlive: true,
  keepAliveMsecs: 60000,
});
이 코드를 보고 'HTTP 연결을 60초 동안 유지한다'고 해석할 수 있다. 하지만 정확한 의미는 다르다. keepAliveMsecs는 TCP Keep-Alive 패킷을 통한 연결 상태 탐지의 초기 지연과 관련된 설정이다.
유휴 HTTP 소켓을 정확히 60초 후에 제거하는 설정이 아니다. HTTP Keep-Alive 연결 재사용과 TCP Keep-Alive 상태 탐지는 서로 구분해야 한다. 이 차이를 이해하지 못하면 타임아웃을 조정했는데도 기대한 대로 동작하지 않는 상황을 겪을 수 있다.
7. 문제를 확인하기 위해 재현 환경을 구성해 보자
간헐적인 네트워크 오류를 분석할 때는 오류가 발생할 수 있는 조건을 통제하는 것이 중요하다. 이번 사례에서도 외부 API 서버의 짧은 유휴 연결 종료 시간을 기준으로 재현 조건을 생각할 수 있었다.
아래 코드는 해당 현상을 이해하기 위해 별도로 구성한 최소 재현 예시다. 실제 운영 서버의 코드를 그대로 가져온 것은 아니다.
① 유휴 연결을 약 1초 후 종료하는 서버
// server.js
const http = require('node:http');

const server = http.createServer((req, res) => {
  res.writeHead(200, {
    'Content-Type': 'application/json',
  });

  res.end(
    JSON.stringify({
      success: true,
      timestamp: Date.now(),
    }),
  );
});

server.keepAliveTimeout = 1000;

// 재현 환경에서는 내부 종료 버퍼를 0으로 설정
// Node.js 버전에서 지원하는 경우에만 적용
if ('keepAliveTimeoutBuffer' in server) {
  server.keepAliveTimeoutBuffer = 0;
}

server.listen(3000, () => {
  console.log('Server listening on port 3000');
});
이 서버는 요청이 정상적으로 완료된 뒤 유휴 상태가 일정 시간 지속되면 연결을 종료하도록 구성되어 있다. 여기서 설정한 keepAliveTimeout은 요청 처리에 허용되는 최대 시간이 아니라, 응답이 완료된 후 다음 요청을 기다리는 시간과 관련된 값이다.
② Keep-Alive를 사용하는 클라이언트
// client.js
const http = require('node:http');

const agent = new http.Agent({
  keepAlive: true,
  maxSockets: 1,
  maxFreeSockets: 1,
});

function requestApi() {
  return new Promise((resolve, reject) => {
    const req = http.get(
      'http://localhost:3000/api',
      { agent },
      (res) => {
        res.resume();

        res.on('end', () => {
          resolve({
            status: res.statusCode,
            reusedSocket: req.reusedSocket,
          });
        });
      },
    );

    req.on('error', reject);
  });
}

async function sleep(ms) {
  return new Promise((resolve) =>
    setTimeout(resolve, ms),
  );
}

async function main() {
  for (let i = 0; i < 100; i++) {
    try {
      const result = await requestApi();

      console.log(
        `[${i}] success`,
        result,
      );
    } catch (error) {
      console.error(
        `[${i}] failed`,
        error.code,
        error.message,
      );
    }

    // 서버 종료 시점 부근에서 요청하도록 조절
    await sleep(1000);
  }

  agent.destroy();
}

main().catch(console.error);
이 테스트에서는 하나의 소켓을 재사용하도록 제한하고, 각 요청 사이에 약 1초의 간격을 두었다. 핵심은 서버의 유휴 연결 종료 시점과 다음 요청 시점을 가깝게 만드는 것이다.
단, 이 코드에서 반드시 ECONNRESET이 발생하는 것은 아니다. 서버가 연결을 정상 종료하고 클라이언트가 이를 먼저 감지한다면 새로운 소켓을 생성해 요청을 처리한다. 오류를 재현하려면 실제 연결 종료 시점, 운영체제의 소켓 처리, 이벤트 루프 타이밍 등이 맞아떨어져야 한다. 따라서 900ms, 1000ms, 1100ms 등 요청 간격을 달리하면서 오류 발생 패턴을 확인하는 것이 좋다.
③ reusedSocket 확인하기
Node.js의 HTTP 요청 객체에서는 기존 소켓을 재사용했는지 확인할 수 있다.
console.log(req.reusedSocket);결과는 다음과 같이 나타날 수 있다.
false  // 새 연결 생성
true   // 기존 연결 재사용
이 값을 오류 발생 시점과 함께 기록하면 유용하다.
예를 들어 다음과 같은 정보를 수집할 수 있다.
requestId=001
reusedSocket=false
status=200

requestId=002
reusedSocket=true
status=200

requestId=003
reusedSocket=true
error=ECONNRESET
이는 가능한 진단 로그의 예시다. 만약 실패한 요청이 기존 소켓을 재사용한 경우에 집중되어 있다면, Keep-Alive와 소켓 재사용 문제를 의심할 근거가 된다. 하지만 이것만으로 서버가 먼저 연결을 종료했는지까지 확정되는 것은 아니다. 필요하다면 TCP 패킷 캡처를 통해 FIN과 RST의 발생 시점을 추가로 확인할 수 있다.
8. 그렇다면 어떻게 개선해야 할까?
원인을 의심하는 것과 실제로 개선하는 것은 다른 문제다.
이번 사례처럼 외부 API 서버가 유휴 연결을 짧게 유지하는 상황이라면 몇 가지 해결 방향을 생각해 볼 수 있다.
방법 1. 클라이언트 유휴 소켓 유지 시간을 짧게 설정하기
가장 먼저 검토할 수 있는 방법은 외부 서버가 연결을 종료하기 전에 클라이언트가 유휴 소켓을 먼저 정리하도록 하는 것이다. 다만 Node.js 기본 http.Agent와 별도 라이브러리는 지원하는 설정이 다르다. 예를 들어 agentkeepalive 라이브러리에서는 freeSocketTimeout을 설정할 수 있다.
npm install agentkeepaliveimport { HttpAgent } from 'agentkeepalive';
const agent = new HttpAgent({
keepAlive: true,
maxSockets: 100,
maxFreeSockets: 10,
// 외부 서버의 약 1초 유휴 종료보다 짧게 설정
freeSocketTimeout: 500,
});위 설정은 유휴 소켓을 약 500ms 이후 정리하도록 구성한 예시다. 외부 서버가 약 1초 후 연결을 종료한다면 클라이언트가 먼저 유휴 소켓을 정리하도록 만들어 경쟁 구간을 줄이는 접근이다. 다만 500ms는 실제 성능 측정과 장애 재현을 거쳐 결정해야 하는 예시 값이다. 이 값을 지나치게 짧게 설정하면 소켓 재사용 효과가 줄어들어 TCP 연결 생성 횟수가 증가할 수 있다.
방법 2. HTTP Keep-Alive를 비활성화하기
외부 API 호출 빈도가 낮거나, 소켓 재사용으로 발생하는 문제가 운영상 더 큰 부담이라면 연결 재사용을 하지 않는 방법도 검토할 수 있다.
import * as http from 'node:http';

const agent = new http.Agent({
  keepAlive: false,
});
또는 요청별로 연결 재사용을 방지하는 방식으로 구성할 수 있다. 이 방법은 새 요청에서 오래된 유휴 소켓을 재사용하는 문제를 피하는 데 도움이 된다. 하지만 모든 요청에서 새로운 연결을 생성한다면 연결 설정 비용이 증가한다. 따라서 트래픽이 많은 서비스에서는 무조건 Keep-Alive를 끄는 것이 정답은 아니다.
방법 3. 서버와 클라이언트의 연결 정책 맞추기
외부 서버의 설정을 변경할 수 있다면 서버와 클라이언트의 연결 유지 정책을 함께 검토할 수 있다.
예를 들어 다음과 같은 구성을 생각해 볼 수 있다.
서버 유휴 연결 유지: 5초
클라이언트 유휴 소켓 유지: 4초
이처럼 클라이언트가 서버보다 먼저 유휴 소켓을 정리하도록 구성하면 종료 시점 경쟁 가능성을 줄일 수 있다. 다만 이는 절대적인 보장 조건이 아니다. 로드밸런서, Nginx, API Gateway처럼 중간에 연결을 관리하는 장비가 있다면 해당 장비의 타임아웃도 함께 고려해야 한다. 또한 서버가 예고 없이 연결을 종료하는 상황까지 완전히 제거할 수는 없다.
방법 4. 실패한 요청에 재시도 정책 적용하기
일시적인 네트워크 오류에 대해 제한적으로 재시도하는 것도 방법이다.
async function requestWithRetry(
  requestFn: () => Promise<unknown>,
) {
  try {
    return await requestFn();
  } catch (error) {
    if (
      isNetworkReset(error)
    ) {
      return await requestFn();
    }

    throw error;
  }
}
하지만 여기서 반드시 주의해야 할 점이 있다. 모든 API 요청을 무조건 재시도해서는 안 된다.
예를 들어 주문 생성이나 결제 요청은 서버에서 이미 처리되었지만 클라이언트가 응답을 받지 못했을 수 있다. 이때 동일한 요청을 다시 보내면 중복 주문이나 중복 결제가 발생할 위험이 있다.
따라서 재시도는 다음과 같은 기준으로 적용해야 한다.
- GET처럼 일반적으로 멱등성이 보장되는 요청인지
- POST라도 Idempotency Key 등 중복 방지 장치가 있는지
- 서버가 요청을 처리했는지 확인할 수 있는지
- 재시도 횟수와 지연 시간이 적절한지
특히 ECONNRESET이라는 오류 코드만으로 서버가 요청을 처리하지 않았다고 판단해서는 안 된다.
9. NestJS에서 외부 API를 호출할 때 고려할 점
NestJS에서는 HttpModule과 HttpService를 사용해 외부 API를 호출하는 경우가 많다.
이때 내부적으로 사용하는 Axios의 HTTP Agent를 명시적으로 설정할 수 있다.
import { Module } from '@nestjs/common';
import { HttpModule } from '@nestjs/axios';
import { HttpAgent } from 'agentkeepalive';

@Module({
  imports: [
    HttpModule.register({
      timeout: 5000,

      httpAgent: new HttpAgent({
        keepAlive: true,
        maxSockets: 100,
        maxFreeSockets: 10,
        freeSocketTimeout: 500,
      }),
    }),
  ],
})
export class ExternalApiModule {}
위 코드는 HTTP 기반 API 호출을 위한 예시다. HTTPS를 사용하는 외부 API라면 HTTPS에 맞는 Agent를 설정해야 한다.
여기서 timeout: 5000은 Axios 요청의 타임아웃과 관련된 설정이다. 반면 freeSocketTimeout: 500은 요청 완료 후 재사용 대기 중인 유휴 소켓을 관리하는 설정이다. 두 값은 목적이 다르다.
서로 다른 타임아웃 이해하기
단순히 어떤 타임아웃을 늘리거나 줄이기보다는, 해당 타임아웃이 정확히 어떤 단계에 적용되는지 이해하고 설정해야 한다.
10. 실제 운영 환경에서는 어떻게 확인해야 할까?
로컬 재현 환경에서 오류가 발생했다고 해서 운영 장애의 원인이 완전히 증명되는 것은 아니다. 실제 운영 환경에서는 클라이언트와 외부 서버 사이에 여러 구성 요소가 존재할 수 있다.
[NestJS Application]
        |
        v
[HTTP Agent]
        |
        v
[TCP Connection]
        |
        v
[Proxy / Load Balancer]
        |
        v
[External API Server]
이때 연결을 종료하는 주체는 반드시 외부 API 애플리케이션이라고 볼 수 없다. 중간 프록시나 로드밸런서에서 유휴 연결을 종료할 수도 있다. 따라서 다음 항목들을 함께 살펴봐야 한다.
요청 로그
- 요청 발생 시간
- 요청 대상 호스트
- 요청 성공 여부
- 오류 코드
- 응답 시간
- 기존 소켓 재사용 여부
소켓 관련 정보
- 소켓 생성 시점
- 소켓 종료 시점
- 연결 종료 이벤트 발생 여부
- 유휴 소켓 수
- 사용 중인 소켓 수
네트워크 설정
- API 서버 Keep-Alive 정책
- Nginx 또는 로드밸런서 타임아웃
- HTTP Agent 설정
- 네트워크 연결 종료 패턴
Linux에서는 다음과 같은 명령으로 연결 상태를 확인할 수도 있다.
ss -tan특정 대상의 TCP 연결을 확인하거나, 네트워크 패킷을 캡처해 종료 과정을 분석할 수도 있다.
sudo tcpdump -i any host <TARGET_IP> \
  and port <TARGET_PORT> -nn
다만 패킷 캡처는 운영 정책과 권한을 확인한 뒤 수행해야 한다. TCP FIN은 정상적인 연결 종료 절차에서 나타날 수 있고, RST는 연결 재설정 등을 나타낼 수 있다. 패킷의 방향과 시점을 함께 분석하면 어느 쪽에서 연결 종료를 시작했는지 확인하는 데 도움이 된다.
11. 장애 분석에서 중요한 것은 설정값이 아니라 연결 생명주기였다
이번 문제를 분석하면서 가장 크게 바뀐 생각은 이것이었다. 처음에는 socket hang up이 단순히 서버가 응답을 주지 않아서 발생하는 오류라고 생각했다. 하지만 HTTP 요청은 단순히 요청을 보내고 응답을 받는 것만으로 이루어져 있지 않다. 그 아래에는 TCP 연결 생성, 재사용, 유휴 상태 관리, 연결 종료라는 과정이 존재한다.
그리고 HTTP Agent는 이 연결들을 애플리케이션 대신 관리한다. 따라서 API 자체가 정상이라고 해도 네트워크 연결 상태에 따라 요청은 실패할 수 있다. 특히 이번 사례에서는 외부 서버가 약 1초 후 유휴 연결을 종료하는 반면, 빌더 측에서는 60초의 연결 관련 설정이 확인되었다. 이 차이 때문에 소켓 재사용 시점과 서버의 연결 종료 시점이 충돌하는 상황을 주요 원인 후보로 분석했다.
하지만 타임아웃 차이만으로 실제 장애 원인이 완전히 증명되는 것은 아니다. 정확한 원인 확정을 위해서는 다음과 같은 근거가 필요하다.
- 오류가 발생한 요청에서 기존 소켓이 재사용되었는지 확인
- 외부 서버 또는 중간 장비의 실제 연결 종료 시점 확인
- 종료 시점 부근에서 오류가 집중되는지 재현
- 클라이언트의 유휴 소켓 유지 시간을 조정한 뒤 오류 감소 여부 비교
이 과정이 중요한 이유는 단순히 설정값 하나를 수정하는 것보다, 왜 그 설정이 필요한지 설명할 수 있는 근거를 확보하는 것이 더 중요하기 때문이다.
마무리하며
이번 문제를 경험하기 전까지 HTTP Keep-Alive는 단순히 서버와 클라이언트의 연결을 재사용해 성능을 개선하는 기능이라고만 생각했다. 하지만 실제 운영 환경에서는 연결을 언제 생성하고, 언제 재사용하고, 언제 종료하는지가 서비스 안정성에도 영향을 미칠 수 있다는 사실을 알게 되었다.
특히 Node.js의 HTTP Agent가 소켓을 관리하는 방식과 서버의 Keep-Alive 정책을 함께 이해하는 것이 중요했다. 이런 문제를 해결하기 위해서는 애플리케이션 로직만이 아니라 그 아래에 있는 네트워크 계층까지 살펴봐야 한다. 아직 배울 것도 많지만, 이번 경험을 통해 장애가 발생했을 때 확인해야 할 범위가 조금 더 넓어진 것 같다.
참고 자료
- Node.js 공식 문서 — HTTP / http.Agent
- Node.js 공식 문서 — Net / TCP Socket
- agentkeepalive GitHub
- MDN — HTTP Connection Management
본 글은 실무에서 경험한 네트워크 연결 문제와 재현 실험을 바탕으로 작성했습니다. 내부 시스템 정보는 익명화했으며, 코드 및 일부 로그는 동작 원리를 설명하기 위해 재구성했습니다. 실제 운영 장애의 최종 원인 확정과 개선 후 효과 측정은 별도로 구분했습니다.
댓글
익명 캐릭터로 가볍게 이야기를 남겨 주세요.